
Roboter-Fitnessstudios: Milliarden für das Training physischer KI
Robotiklabore investieren Milliarden, um den kritischen Mangel an Trainingsdaten für physische KI-Systeme zu überwinden.
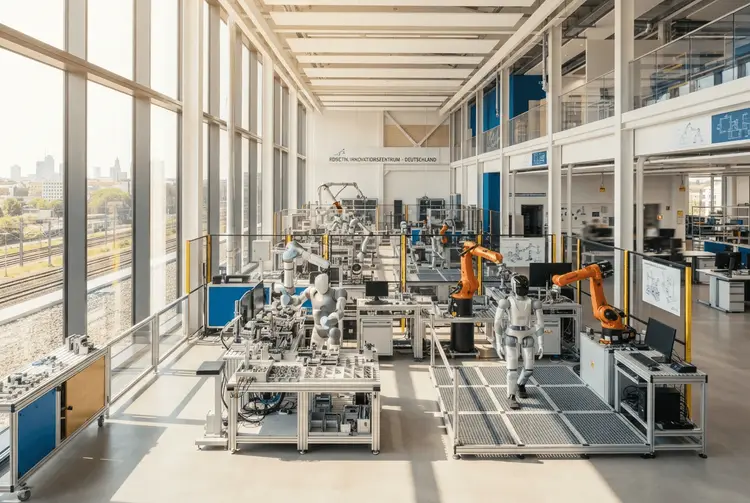
Robotiklabore weltweit stehen vor einem fundamentalen Problem: Anders als KI-Modelle, die das Internet als nahezu unerschöpfliche Datenquelle nutzen konnten, fehlt es Robotikunternehmen an ausreichendem Trainingsmaterial. Die Branche reagiert mit massiven Investitionen – Milliarden von US-Dollar fließen in die Erzeugung von Realdaten, die Maschinen auf die Anforderungen der physischen Welt vorbereiten sollen.
Der Engpass ist struktureller Natur. Während Sprachmodelle und andere textbasierte KI-Systeme auf riesige Mengen digitaler Inhalte zurückgreifen konnten, benötigen Roboter einen weitaus vielfältigeren und komplexeren Datensatz. Bewegungsabläufe, physische Interaktionen, räumliches Verständnis – all das lässt sich nicht einfach aus dem Netz scrapen. Genau hier liegt der entscheidende Unterschied zwischen der Entwicklung von Sprachmodellen und der sogenannten „physischen KI".
Die Lösung, die sich die Branche erarbeitet, erinnert an Fitnessstudios für Maschinen: spezialisierte Umgebungen, in denen Roboter unter kontrollierten Bedingungen trainiert werden, um Fähigkeiten für die reale Welt zu erlernen. Diese „Roboter-Fitnessstudios" sind kostspielig, aber offenbar unverzichtbar für den Fortschritt der gesamten Branche.
Die Details
Der Kern des Problems liegt im Datenmangel. Start-ups im Bereich der physischen KI – also Unternehmen, die Roboter entwickeln, die in der realen Welt agieren sollen – kämpfen mit einem Engpass, der ihre Entwicklung spürbar bremst. Im Gegensatz zu den Entwicklern von KI-Modellen, die große Teile des Internets für ihre Systeme ausgelesen haben, steht der Robotikindustrie keine vergleichbare Datenquelle zur Verfügung.
Um dieses Defizit zu überwinden, geben Robotiklabore Milliarden von US-Dollar aus. Das Ziel: die für das Training ihrer Maschinen benötigten Realdaten selbst zu generieren. Dieser Ansatz ist aufwendig und teuer, gilt aber als notwendig, um die Entwicklung physischer KI voranzutreiben. Die Daten müssen die Komplexität der realen Welt abbilden – mit all ihren Unwägbarkeiten, variierenden Lichtverhältnissen, unterschiedlichen Oberflächen und unvorhersehbaren Situationen.
Der Unterschied zu textbasierten Modellen ist dabei gravierend. Ein Sprachmodell lernt aus Milliarden von Texten, die bereits digital vorlagen. Ein Roboter hingegen muss lernen, wie er einen Gegenstand greift, wie er sich in einem unbekannten Raum orientiert oder wie er auf unerwartete Hindernisse reagiert. Diese Daten existieren nicht in digitaler Form – sie müssen durch reale oder simulierte Experimente erst erzeugt werden.
Hintergrund: Was bisher geschah
Das Thema Robotik-Training beschäftigt die Branche schon länger. Bereits am 18. September 2026 berichtete aktien.news über einen bemerkenswerten Ansatz aus Großbritannien: Das Cambridge-Start-up Vsim, gegründet von Michelle Lu und Kier Storey, entwickelte eine Simulationssoftware, die Roboter in Rekordzeit neue Fähigkeiten erlernen lässt. Ihr Roboter Freddo benötigte demnach nur wenige Minuten, um Laufen, Objekterkennung und Greifbewegungen zu erlernen – für konkurrierende Systeme dauerte dasselbe nach Angaben der Gründer Tage. Dieser Bericht illustriert, wie intensiv die Suche nach effizienteren Trainingsmethoden bereits läuft.
Am 29. April 2026 beleuchtete aktien.news den breiteren KI-Wettlauf: OpenAI, Anthropic, Google DeepMind, xAI und Meta konkurrieren um die Vorherrschaft in der künstlichen Intelligenz. Dieser Kontext ist relevant, weil der Wettbewerb im Bereich der physischen KI als eine der nächsten großen Fronten in diesem Rennen gilt – mit dem entscheidenden Unterschied, dass hier nicht Rechenleistung und Textdaten, sondern physische Trainingsdaten den Ausschlag geben.
Auch am 28. September 2026 zeigte sich, wie stark Kostenfragen die KI-Branche prägen: US-Konzerne wenden sich zunehmend günstigeren offenen KI-Modellen zu, weil explodierende IT-Kosten Alternativen erzwingen. Dieser Kostendruck dürfte auch im Robotikbereich eine Rolle spielen, wo die Datengenerierung besonders teuer ist.
Was das für Anleger bedeutet
Für deutsche Privatanleger ist der Bereich physische KI und Robotik ein Thema mit wachsender Relevanz. Der Milliarden-Aufwand für Trainingsdaten zeigt, dass die Branche noch in einer frühen, kapitalintensiven Phase steckt. Unternehmen, die in der Lage sind, effizient und kostengünstig hochwertige Trainingsdaten zu generieren – sei es durch reale Experimente oder durch Simulationssoftware –, könnten sich einen entscheidenden Wettbewerbsvorteil erarbeiten.
Der Datenmangel als struktureller Engpass bedeutet gleichzeitig, dass der Markt für Lösungen in diesem Bereich erheblich ist. Wer das Datenproblem löst, löst einen der zentralen Flaschenhälse der gesamten Robotikindustrie. Das macht Unternehmen, die an Trainingsinfrastruktur, Simulationssoftware oder Datenerfassungssystemen arbeiten, zu potenziell interessanten Beobachtungsobjekten – auch wenn konkrete Investitionsentscheidungen stets eine gründliche eigene Analyse erfordern.
Anleger sollten zudem beachten, dass die hohen Investitionskosten in der Branche auf eine lange Vorlaufzeit bis zur Profitabilität hindeuten. Die Milliarden, die heute in Trainingsdaten fließen, sind Vorleistungen für Produkte, die erst in einigen Jahren marktreif sein könnten.
Ausblick
Konkrete Termine oder Meilensteine nennt der vorliegende Bericht nicht. Klar ist jedoch, dass der Wettlauf um Trainingsdaten für physische KI weiter an Intensität gewinnen dürfte. Die Branche hat das Datenproblem als zentralen Engpass identifiziert, und die Investitionsbereitschaft – gemessen in Milliarden von US-Dollar – signalisiert, dass die großen Akteure entschlossen sind, diesen Engpass zu überwinden. Wie schnell das gelingt, hängt maßgeblich davon ab, ob sich effizientere Methoden zur Datengenerierung durchsetzen können.
Kurz erklärt
- Physische KI: Künstliche Intelligenz, die nicht nur digitale Inhalte verarbeitet, sondern in der realen, physischen Welt agiert und mit ihr interagiert.
- Trainingsdaten: Datenmaterial, das verwendet wird, um einem KI-System oder Roboter beizubringen, wie es auf bestimmte Situationen reagieren soll.
- Simulationssoftware: Programme, die reale Umgebungen und Szenarien virtuell nachbilden, damit Roboter darin trainieren können, ohne physische Experimente durchführen zu müssen.